
En los sistemas modernos, fallar no siempre significa detenerse. Un sistema puede mantenerse activo y, aun así, haber perdido su capacidad de respuesta. Este tipo de degradación es crítica porque no se percibe como una caída inmediata, sino como una pérdida progresiva de rendimiento.
Fuente: https://aws.amazon.com/es/message/101925/
En 2025, AWS experimentó un incidente en su región us-east-1 originado por una condición de carrera en el sistema de gestión DNS de DynamoDB. Aunque el origen fue estructural, el impacto se reflejó principalmente en el performance del sistema.
El sistema comenzó a degradarse progresivamente, evidenciando:
• Incremento en los tiempos de respuesta.
• Aumento de errores.
• Dificultades para completar operaciones.
Aunque en ciertos momentos los servicios respondían, su capacidad de procesamiento estaba comprometida y se generaron retrasos acumulativos en procesos internos, prolongando el impacto incluso después de aplicar correcciones. Desde la perspectiva del usuario, esto se tradujo en una pérdida efectiva de rendimiento, donde las aplicaciones no podían operar de forma consistente, afectando directamente la experiencia y la continuidad del negocio. En este contexto, el problema no fue la ausencia de respuesta, sino la incapacidad del sistema para responder con el nivel de performance esperado. 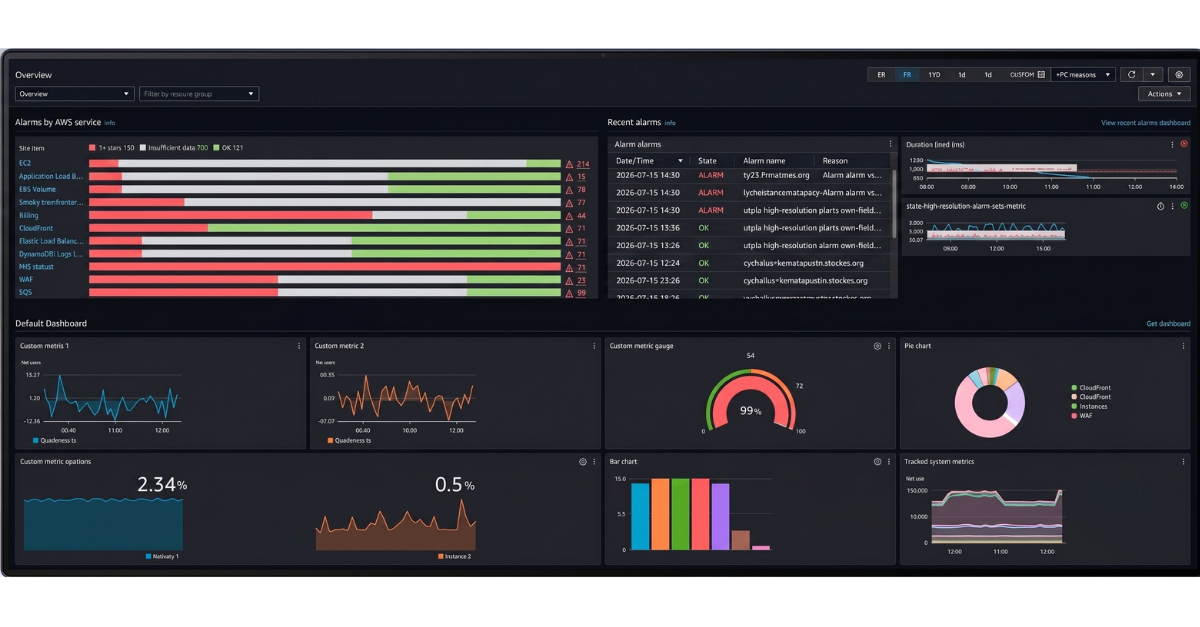
Este caso muestra que el performance es un indicador de la capacidad real de operación del sistema. Para los equipos de calidad, esto implica validar no solo tiempos de respuesta bajo carga, sino también cómo se comporta el sistema cuando existen fallos internos, dependencias degradadas o retrasos acumulativos.
En la práctica, calidad puede contemplar escenarios como degradación de servicios dependientes, fallas intermitentes de comunicación, aumento progresivo de latencia, errores en APIs críticas, acumulación de colas, lentitud en procesos de recuperación y pérdida parcial de observabilidad. Estos escenarios permiten evaluar si el sistema mantiene su operación, se degrada de forma controlada o amplifica el problema.
Pruebas como performance testing, resiliencia, failover, recuperación, pruebas de estrés, pruebas de degradación controlada y validación de monitoreo permiten anticipar estos riesgos. El incidente de Amazon Web Services demuestra que un sistema no necesita caerse para dejar de ser útil. El performance refleja si realmente puede seguir operando cuando las condiciones dejan de ser ideales.